트렌드#LLM#오픈웨이트#MoE
직원 대부분이 노는데 대형 회사랑 맞먹는 회사 실화냐
논문 쉽게 읽기: Mixtral of Experts, '전문가 혼합(MoE)' · 가상의 회사로 시작하는 AI 이야기
직원 대부분이 노는 회사가 있음
노는 직원이 대부분인데 안 망하는 회사 얘기임.
먼저 말해 둠. 가상의 회사임. 정체는 좀 이따 밝힘.
직원이 8명임.
근데 손님 한 명 올 때마다 일하는 건 딱 2명.
나머지 6명은 그 손님 건엔 손도 안 댐.
누가 일할지는 입구의 배정 담당이 정함.
손님 쓱 보고 "이 건은 3번이랑 7번" 하고 찍어 줌.
두 사람 결과물이 오면 "3번 거 많이, 7번 거 조금" 비율 정해서 섞은 다음 손님한테 내보냄.
여기까지 들으면 "6명 월급 루팡 아님?" 싶을 거임.
(엄밀히는 그 손님 건에서만 빠지는 거임. 다음 손님이 오면 배정 담당이 2명을 새로 고름. 아까랑 같은 사람일 수도, 다른 사람일 수도 있음.)
근데 반전 있음.
옆 동네에 손님 한 명 올 때마다 전 직원이 달라붙는 대형 회사가 있음. 손님당 투입 인력이 이 회사의 5배 넘음.
둘이 같은 시험 붙었더니 2명만 일하는 이 회사가 대부분 종목에서 이기거나 비슷하게 나옴.
ㄹㅇ 이 회사 어디 있냐고?
사람 회사는 아님. AI 모델 얘기임.
Mistral AI가 2024년 1월 논문으로 구조를 공개한 Mixtral 8x7B라는 언어 모델 속이 딱 이렇게 생김.
그리고 이번 주 AI 뉴스에 나온 이상한 숫자도 사실 이 회사 얘기임.
이번 주 뉴스 속 '전체 8,160억, 활성 420억'
10월 15일 메타가 새 모델 Muse Spark Open의 오픈 웨이트를 공개함.
화제가 된 건 장소였음. 데이터센터가 아니라 책상 위 Mac Studio(M5 Ultra) 두 대에서 돌아간다는 거임.
발표문엔 이런 숫자가 있음. "전체 파라미터 8,160억 개(활성 420억 개)".
모델 카드엔 "전문가 256개 중 토큰당 8개 활성화"라고 적혀 있음.
직원 256명 중 손님마다 8명만 일하는 회사라는 소리임. 구조 자체는 위에서 본 그 회사랑 같은 발상임.
(※ Muse Spark Open이 Mixtral을 바탕으로 만들어졌다는 뜻은 아님. 같은 설계 아이디어를 이해하는 배경 지식으로 Mixtral 논문을 읽는 거임.)
회사 = AI 모델, 직원 = 전문가
비유랑 실제 개념을 짝지어 보면 이럼.
- 손님 = 토큰. 글을 잘게 쪼갠 조각임. 모델은 문장을 토큰 단위로 하나씩 처리함.
- 직원 = 피드포워드 블록. 논문은 이걸 '전문가(expert)'라고 부름. 층마다 8명 있음.
- 배정 담당 = 라우터. 직원마다 점수를 매겨 상위 2명을 고르고, 그 점수를 두 결과를 섞는 비율로도 씀.
- 회사의 한 층 = 모델의 한 층. Mixtral은 이런 층이 32개 쌓여 있음.
- 전 직원 규모 = 한 토큰이 접근할 수 있는 파라미터 470억 개.
- 그 손님 건에 실제로 일한 직원 = 활성 파라미터 130억 개.
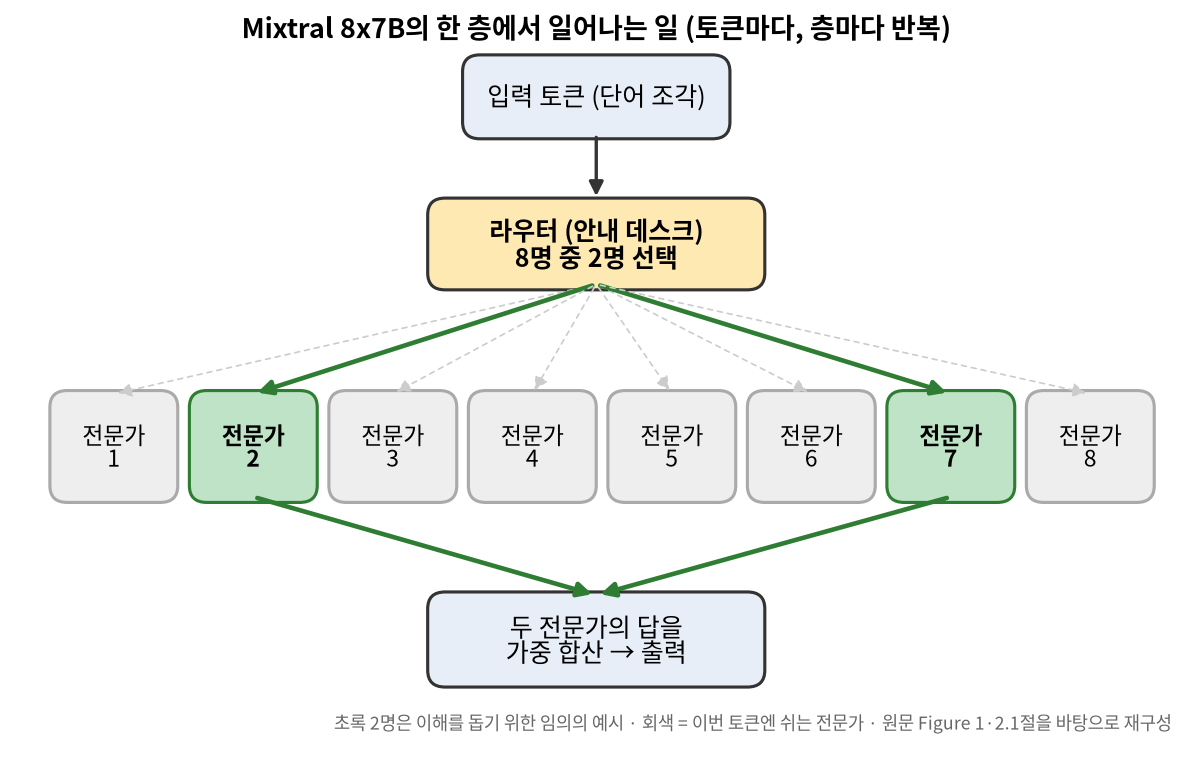
이게 왜 이득이냐면, 논문 설명이 깔끔함.
고르는 수(2명)는 그대로 두고 직원 수만 늘리면, 계산 비용은 사실상 그대로인 채 모델을 키울 수 있음.
회사 실력은 전 직원한테서 나오는데, 손님 한 명당 드는 인건비는 2명분이라는 거임.
물론 실제 MoE는 사람 회사랑 다른 점이 꽤 있음.
- 손님(토큰)은 한 층만 들렀다 가는 게 아님. 32개 층을 전부 거치고, 층마다 배정을 새로 받음. 그래서 같은 토큰이라도 층마다 다른 직원 조합을 만날 수 있음.
- 직원은 월급 받는 사람이 아니라 숫자 덩어리임. 그리고 사람처럼 '전공'이 있는지도 따져 봐야 함. (이게 뒤에 나올 진짜 반전임)
- 일 안 하는 직원도 사무실 자리는 다 있어야 함. 이게 생각보다 중요함. 바로 다음에 나옴.
성적표: 손님당 인력 5분의 1도 안 되는데
비교 상대는 당시 대표 공개 모델 Llama 2 70B임. 이 모델은 토큰마다 700억 개 파라미터를 전부 씀. 위 비유의 '전 직원이 달라붙는 대형 회사'임.
Mixtral은 그 5분의 1도 안 되는 130억 개로 대부분의 벤치마크에서 앞서거나 비슷했음.
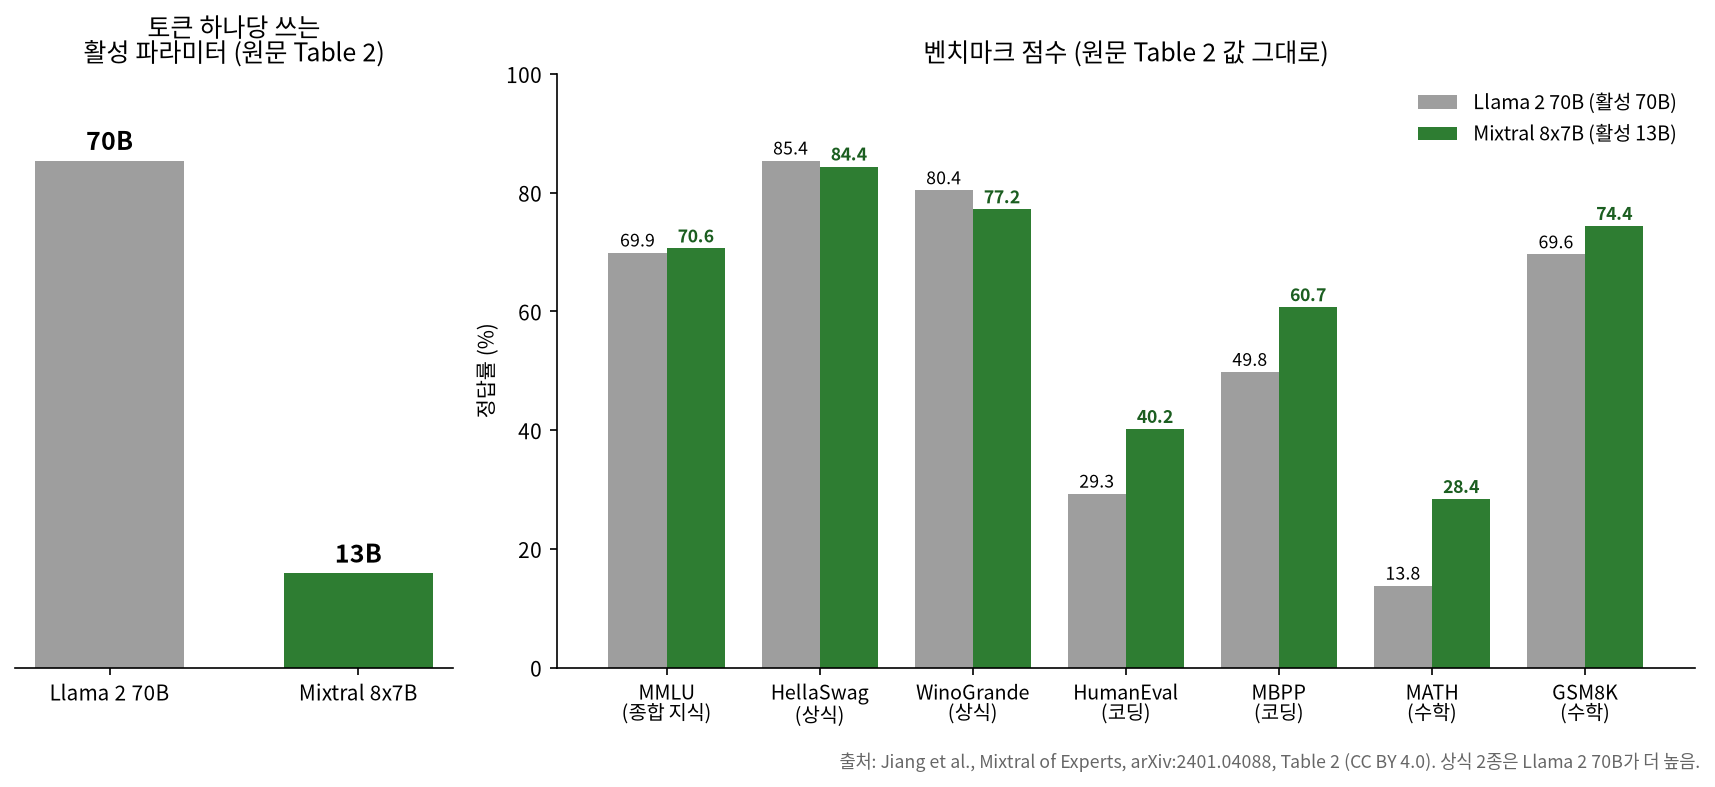
- 종합 지식 시험 MMLU: 70.6% 대 69.9%, 근소하게 앞섬.
- 수학 MATH: 28.4% 대 13.8%, 두 배 넘음.
- 코딩 MBPP: 60.7% 대 49.8%.
- 대신 상식 문제(HellaSwag, WinoGrande)는 Llama 2 70B가 조금 높았음. 전 종목 압승은 아님.
대화용으로 다듬은 Mixtral Instruct는 MT-Bench 8.30점을 받아, 논문 기준 2023년 12월 당시 최고의 오픈 웨이트 모델이 됐음.
공짜 점심은 없음: 사무실은 다 지어야 함
계산을 아낀다고 다 공짜인 건 아님.
논문은 계산 비용은 활성 파라미터에, 메모리 비용은 전체 파라미터(470억 개)에 비례한다고 밝힘.
손님마다 2명만 일해도, 회사는 8명 전원의 책상을 다 깔아 둬야 한다는 얘기임. 배정 담당이 길 안내하는 데도 추가 부담이 생김.
여기서 뉴스가 다시 보임.
메타는 Mac Studio 한 대당 최대 512GB 통합 메모리를 GPU가 쓸 수 있어 두 대면 모델 전체를 담을 수 있고, 초당 1.2TB 메모리 대역폭이면 토큰마다 필요한 작은 조각을 읽기에 충분하다고 설명함.
사무실(메모리)은 넓게, 복도(대역폭)는 빠르게. 이건 메타 측 설명이라 독립적으로 확인된 건 아님.
진짜 반전: 직원들한테 전공이 없었음
그럼 1번 직원은 수학 담당, 2번은 생물학 담당일까?
연구진도 궁금해서 직접 까 봄.
결과는 "놀랍게도" 아니었음. (논문에 진짜 Surprisingly라고 써 있음)
arXiv 논문, 생물학 초록, 철학 문서를 넣어 봤는데 직원 배정 분포가 서로 매우 비슷했음. 주제별 전공이 안 보였다는 거임.
대신 보인 건 문법 패턴이었음.
파이썬 코드의 self, 영어의 'Question' 같은 단어, 코드의 들여쓰기가 같은 직원한테 자주 감.
연달아 오는 토큰들이 같은 직원을 만나는 경향도 강했음.
회사로 치면 '수학팀·생물팀'이 아니라 '문장 속 역할별 담당자'에 가까운 셈임. 처음 비유에서 직원을 사람처럼 상상했으면 여기서 살짝 배신당하는 포인트임.
정리하면
- "전체 OOO억, 활성 OO억" 표기를 보면 전 직원 수 vs 손님 한 명에 실제로 일한 직원 수를 떠올리면 됨.
- 활성이 작으면 계산은 싸짐. 근데 메모리는 전체 크기만큼 필요함. 그래서 책상 위 Mac 얘기에서 메모리 512GB가 핵심 숫자로 나온 거임.
- 전문가는 사람 같은 전공이 아니라, 문법·패턴 단위로 일을 나눠 맡는 경향을 보였음.
다음 글은 같은 AI라도 묻는 방식만 바꿨더니 수학 점수가 3배 넘게 뛴 얘기임. 모델은 하나도 안 고치고 질문만 바꿨는데 그게 됨. '다음에 읽을 글'에서 이어서 보셈.
이 글에서 답하는 질문
AI 모델의 '전체 파라미터'와 '활성 파라미터'는 무엇이 다른가요?
전체 파라미터는 모델이 가진 모든 숫자(지식 저장소)의 개수이고, 활성 파라미터는 글 조각(토큰) 하나를 처리할 때 실제로 계산에 쓰는 개수입니다. 회사에 비유하면 전체는 회사의 전 직원, 활성은 손님 한 명의 일을 실제로 맡은 직원입니다. Mixtral 8x7B는 한 토큰이 470억 개에 접근할 수 있지만 실제 계산에는 130억 개만 씁니다.
전문가 혼합(MoE)은 어떻게 동작하나요?
Mixtral은 32개 층마다 피드포워드 블록 8개(전문가)를 두고, 작은 신경망인 라우터가 토큰마다 8개 중 2개를 골라 두 전문가의 출력을 가중치로 합칩니다. 고르는 수는 그대로 두고 전문가 수만 늘리면 계산 비용은 사실상 그대로인 채 모델을 키울 수 있다는 것이 논문의 설명입니다.
MoE 모델은 메모리도 적게 쓰나요?
아닙니다. 논문에 따르면 계산 비용은 활성 파라미터에, 메모리 비용은 전체 파라미터에 비례합니다. 메타는 Mac Studio 한 대당 최대 512GB 통합 메모리를 쓸 수 있어 두 대면 Muse Spark Open 모델 전체를 담을 수 있다고 설명했는데, 이는 메타 측 주장입니다.
이 글은 AI가 작성하고 원문과 대조 검증했습니다. 그래도 오류가 있을 수 있으니 중요한 내용은 원문 논문으로 확인해 주세요.
원문 논문
- 제목
- Mixtral of Experts
- 저자
- Albert Q. Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch 외 (총 26명, Mistral AI)
- 출처
- arXiv:2401.04088 (v1, 2024-01-08)
- 링크
- 초록 페이지 · PDF
- 라이선스
- CC BY 4.0 (전문)
arXiv 초록 페이지 표기 기준. PDF에 나오는 Apache 2.0은 논문이 아니라 모델 가중치의 라이선스입니다
이 글은 위 논문을 한국어로 번역·요약하고 비유와 도식을 더해 재구성한 글입니다. 원문과 다른 표현이 있을 수 있습니다.
용어 카드 모아보기
본문의 밑줄 친 용어를 누르면 그 자리에서 펼쳐집니다.
파라미터
AI 모델이 학습하면서 조정하는 숫자들로, 모델이 배운 지식이 저장되는 곳임. 개수가 많을수록 담을 수 있는 정보가 많지만, 저장할 메모리와 계산량도 늘어남.
비유 거대한 믹싱 콘솔의 손잡이들. 수십억 개 손잡이 위치가 모여 하나의 '소리(답)'를 만듦.
이 용어가 나오는 다른 글: 답만 찍던 과외생, 풀이 적힌 예제만 보여 줬더니 성적 떡상한 썰 푼다
토큰
AI가 글을 읽고 쓰는 최소 단위로, 단어 하나일 수도 있고 단어의 조각일 수도 있음. 모델은 문장을 토큰으로 잘게 나눈 뒤 하나씩 처리함.
비유 회사에 찾아오는 손님 한 명 한 명.
라우터
전문가 혼합 모델에서 들어온 토큰을 어떤 전문가에게 보낼지 정하는 작은 신경망임. Mixtral에서는 전문가마다 점수를 매긴 뒤 상위 2개를 고르고, 그 점수를 두 출력을 합칠 때의 비중으로도 씀.
비유 손님 보고 담당 직원 2명 찍어 주는 입구의 배정 담당.
피드포워드 블록
트랜스포머 모델의 각 층에 들어 있는 계산 부품으로, 입력 정보를 가공해 다음 층으로 넘김. Mixtral은 층마다 이 블록 하나 대신 8개를 두고, 각각을 '전문가'라고 부름.
비유 층마다 8명 있는 직원. 손님마다 그중 2명만 일함.
벤치마크
AI 성능을 비교하려고 만든 표준 시험 문제 모음임. MMLU(57개 과목 객관식), MATH(수학), MBPP(코딩)처럼 영역별로 따로 있음.
비유 수능 모의고사. 같은 시험지를 풀어야 누가 잘하는지 공정하게 비교됨.
오픈 웨이트
학습이 끝난 모델의 파라미터 값(가중치)을 누구나 내려받을 수 있게 공개하는 방식임. 학습 데이터나 학습 코드까지 다 공개한다는 뜻은 아니고, 사용 조건은 라이선스마다 다름.
비유 완성된 요리의 레시피 카드를 나눠 주는 것. 재료를 어디서 샀는지까지 알려 주는 건 아님.
관련 키워드
- 전문가 혼합 MoE 뜻
- MoE 모델 원리
- 활성 파라미터란
- 메타 Muse Spark Open
- 8160억 파라미터
- Mixtral 8x7B 논문
- MoE 라우터 토큰
- 오픈 웨이트 뜻
- Mac Studio LLM 구동
- 오픈소스 AI 오픈 웨이트 차이
출처·검증 메모
- 논문: Albert Q. Jiang, Alexandre Sablayrolles, Antoine Roux, Arthur Mensch 외(총 26명, Mistral AI). Mixtral of Experts. arXiv:2401.04088v1 [cs.LG], 2024-01-08 제출.
- 링크: https://arxiv.org/abs/2401.04088 (PDF: https://arxiv.org/pdf/2401.04088, 13쪽, v1 확인)
- 라이선스:
- arXiv 초록 페이지 표기: CC BY 4.0 (http://creativecommons.org/licenses/by/4.0/).
- PDF 본문: 논문 자체에 대한 저작권 문구(©, copyright 등)는 없음. PDF에 나오는 "Apache 2.0"(초록, 1절, 6절)은 모델 가중치(Mixtral 8x7B / Instruct)의 라이선스이며 논문 텍스트의 라이선스가 아님. 두 표기가 서로 다른 대상을 가리키므로 충돌로 보지 않음. 이 글의 번역·요약·도표 재구성은 CC BY 4.0 조건(저작자 표시, 변경 사실 표시)에 따름. 그림 1·2는 원문 그림을 복제하지 않고 원문 내용·수치로 새로 그림.
글에 쓴 수치와 원문 위치
| 수치/주장 | 원문 위치 |
|---|---|
| 층마다 피드포워드 블록 8개(전문가), 라우터가 토큰·층마다 2개 선택, 출력 가중 합산 | 초록, 1절, Figure 1 캡션, 2.1절 |
| 32개 층(n_layers 32), num_experts 8, top_k_experts 2 | Table 1 |
| 선택 전문가는 시점(토큰)마다 달라질 수 있음 | 초록 |
| 접근 47B / 활성 13B 파라미터 | 초록, 3절 Size and Efficiency, 6절 |
| K 고정·n 증가 시 계산 비용 사실상 일정, 전체 vs 활성 파라미터 구분 | 2.1절 |
| 활성 파라미터 5배 적음(5x fewer), 대부분 지표에서 Llama 2 70B 이상 | Table 2 캡션, 3절 |
| MMLU 70.6 vs 69.9, HellaSwag 84.4 vs 85.4, WinoGrande 77.2 vs 80.4, HumanEval 40.2 vs 29.3, MBPP 60.7 vs 49.8, MATH 28.4 vs 13.8, GSM8K 74.4 vs 69.6 | Table 2 (그림 2의 모든 값) |
| MT-Bench 8.30, 2023년 12월 기준 최고 오픈 웨이트 모델 | 4절 |
| 계산 비용 ∝ 활성 파라미터, 메모리 비용 ∝ 전체 파라미터(47B), 라우팅 오버헤드 | 3절 Size and Efficiency |
| 주제별 전문가 배정 패턴 없음("Surprisingly"), arXiv·PubMed·PhilPapers 분포 유사 | 5절, Figure 7 |
self, 'Question', 들여쓰기 토큰이 같은 전문가로 감, 연속 토큰 같은 전문가 경향 |
5절, Figure 8, Table 5 |
뉴스 출처(트렌드 연동)
- 메타 공식 블로그 "Introducing Muse Spark Open"(2026-10-15): https://research.meta.ai/blog/muse-spark-open — 816B 전체(42B 활성), 두 대의 M5 Ultra Mac Studio에서 구동, 대당 최대 512GB 통합 메모리·1.2TB/s 대역폭 및 "각 토큰에 필요한 작은 조각" 설명, Muse Model License(제한적 상업 조건).
- Hugging Face 모델 카드: https://huggingface.co/meta-models/Muse-Spark-Open-816B-A42B-NVFP4 — "Mixture-of-Experts Transformer", 전문가 256개, 토큰당 8개 활성(top-k routing).
- 메타 개발자 문서(하드웨어): https://dev.meta.ai/docs/muse-spark-open/hardware-platforms — Mac Studio M5 Ultra 2×512GB 또는 4×256GB, MLX.
- 보도: The Verge(2026-10-15) https://www.theverge.com/news/1012293/meta-apple-muse-spark-open-ai-model-mlx , TechCrunch(2026-10-15) https://techcrunch.com/2026/10/15/meta-launches-an-open-weight-model-that-runs-on-macs/ (TechCrunch는 제목·날짜만 확인, 본문은 수집 실패).
확인하지 못한/주의할 부분
- Muse Spark Open과 Mixtral 사이의 직접적인 기술 계보는 확인되지 않음. 글에서는 "같은 설계 아이디어의 배경"으로만 연결함. Muse Spark Open의 성능 수치는 이 글에서 다루지 않음.
- 원문 초록은 "평가한 모든 벤치마크에서 Llama 2 70B 이상이거나 같다"고 쓰지만, Table 2에서는 HellaSwag·WinoGrande·TriviaQA에서 Llama 2 70B가 더 높음(Figure 3 캡션도 독해 영역은 예외라고 적음). 글에서는 "대부분"으로 쓰고 지는 항목을 그림에 함께 표시함.
- 원문 3절에 "47B tokens compared to 70B"라는 표현이 있으나, 문맥상 파라미터의 오기로 보임(초록·3절 다른 문장은 47B parameters). 글에는 "파라미터"로 씀.
- Table 2의 MATH는 maj@4, GSM8K는 maj@8 방식(3절)이라 다른 논문의 수치와 바로 비교하면 안 됨. Llama 모델도 Mistral 측이 자체 파이프라인으로 다시 평가한 값임.
- "활성 5분의 1도 안 된다"는 13B/70B≈0.19로 계산한 값이며, 원문 표현은 "5x fewer"임.
- Mac Studio 관련 설명(메모리·대역폭)은 메타의 주장을 옮긴 것이며 독립적으로 검증하지 않음.
2026-10-17 문체 개정(커뮤니티 음슴체) 메모
- '직원 8명 중 손님마다 2명만 일하는 회사'는 비유용 가상 회사이며 실존 회사·사건이 아님. 본문 첫 줄에 "가상임"을 밝히고 곧이어 "사람 회사는 아님, AI 모델 얘기임"으로 정체를 밝힘.
- 대응 관계: 직원 = 층마다 8개의 피드포워드 블록(전문가), 손님 = 토큰, 배정 담당 = 라우터(상위 2개 선택·가중치 합산), 회사의 층 = 32개 층(Table 1), 전 직원 규모 = 47B, 실제로 일한 직원 = 13B(초록, 3절).
- '옆 대형 회사, 손님당 투입 인력 5배 넘음' = Llama 2 70B(토큰마다 70B 전부 사용) 대비. 70/13 ≈ 5.4이며 원문 표현은 "5x fewer active parameters"(Table 2 캡션).
- '직원 256명 중 8명' = 모델 카드의 "전문가 256개 중 토큰당 8개 활성"을 같은 비유로 옮긴 것. Muse Spark Open이 Mixtral 기반이라는 뜻은 아님(본문에 명시).
- "2024년 1월 논문으로 구조를 공개"는 arXiv v1 제출일(2024-01-08) 기준. 모델 가중치 자체의 최초 공개일은 이 글에서 확인하지 않아 쓰지 않음.
- 이번 개정에서 새로 추가한 성능 수치는 없음. 위 표의 수치를 PDF 텍스트(Table 2, 4절, 5절)에서 다시 대조함.